
로봇기사
Rhoda AI, 영상 데이터로 로봇용 범용 AI 만들기 도전
출처 The Robot Report
한눈에 보기
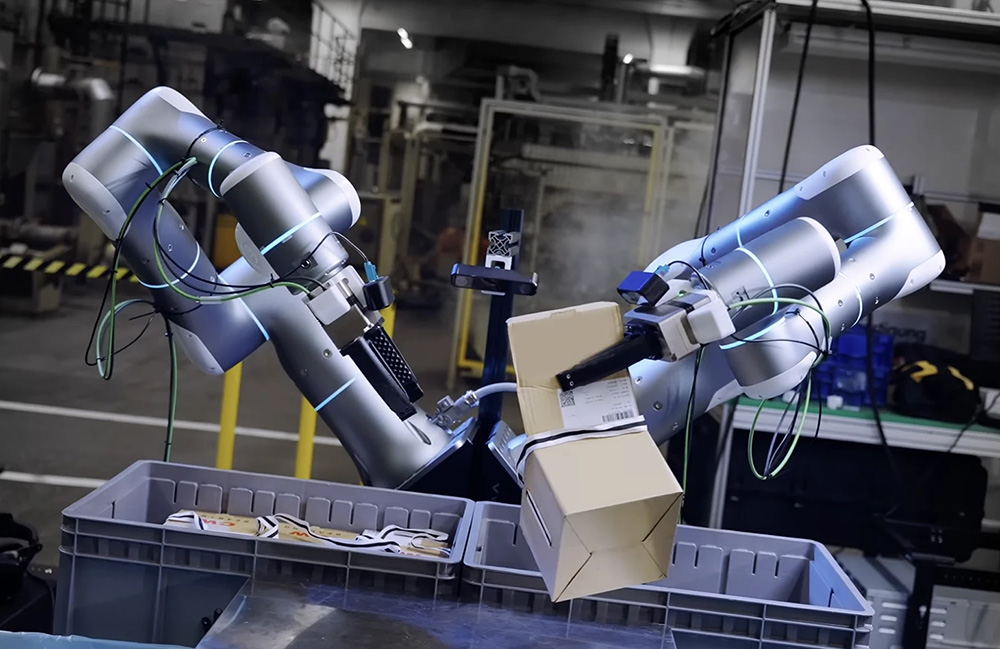
Rhoda AI는 인터넷에 있는 대량의 영상으로 로봇 AI를 학습시켜 여러 상황에 두루 쓸 수 있는 모델을 만들려고 해요. 이 회사는 올해 4억 5천만 달러의 시리즈 A 투자를 받고 자동차, 제조, 물류, 전자상거래 고객과 일하고 있어요.
핵심만 콕콕
회사는 DVA(직접 영상 행동 모델)라는 모델로 로봇을 움직이게 해요.
모델은 영상 장면을 먼저 예측하고, 그 예측을 로봇 동작으로 바꿔 짧게 실행한 뒤 다시 관찰하는 과정을 반복해요.
회사는 학습 데이터가 많을수록 모델이 낯선 상황에서도 덜 무너진다고 말해요.
CEO 집단다 싱은 로봇이 실제 현장 문제를 푸는 경우가 지금은 사실상 없다고 말했어요.
왜 중요할까요?
로봇이 실험실을 벗어나 실제 현장에서 일하려면 데이터 부족 문제를 풀어야 하는데, 이 시도가 그 해법이 될지 지켜볼 만해요.
점선 밑줄이 그어진 말을 누르면 AI 백과의 개념 설명가 열려요.
원문 기사
How Rhoda AI is using video data to create generalized AI models for robots
The Robot Report · 2026년 11월 13일 오후 10:30 · therobotreport.com
The Robot Report에서 원문 읽기이 요약은 AI가 원문을 읽고 쉬운 말로 정리했어요. 틀린 내용이 있을 수 있으니 정확한 내용은 원문에서 확인해 주세요. 기사의 저작권은 The Robot Report에 있어요.