
AI기사
AWS, SageMaker에 GPU 나눠 쓰기 기능 추가
출처 Unite.AI
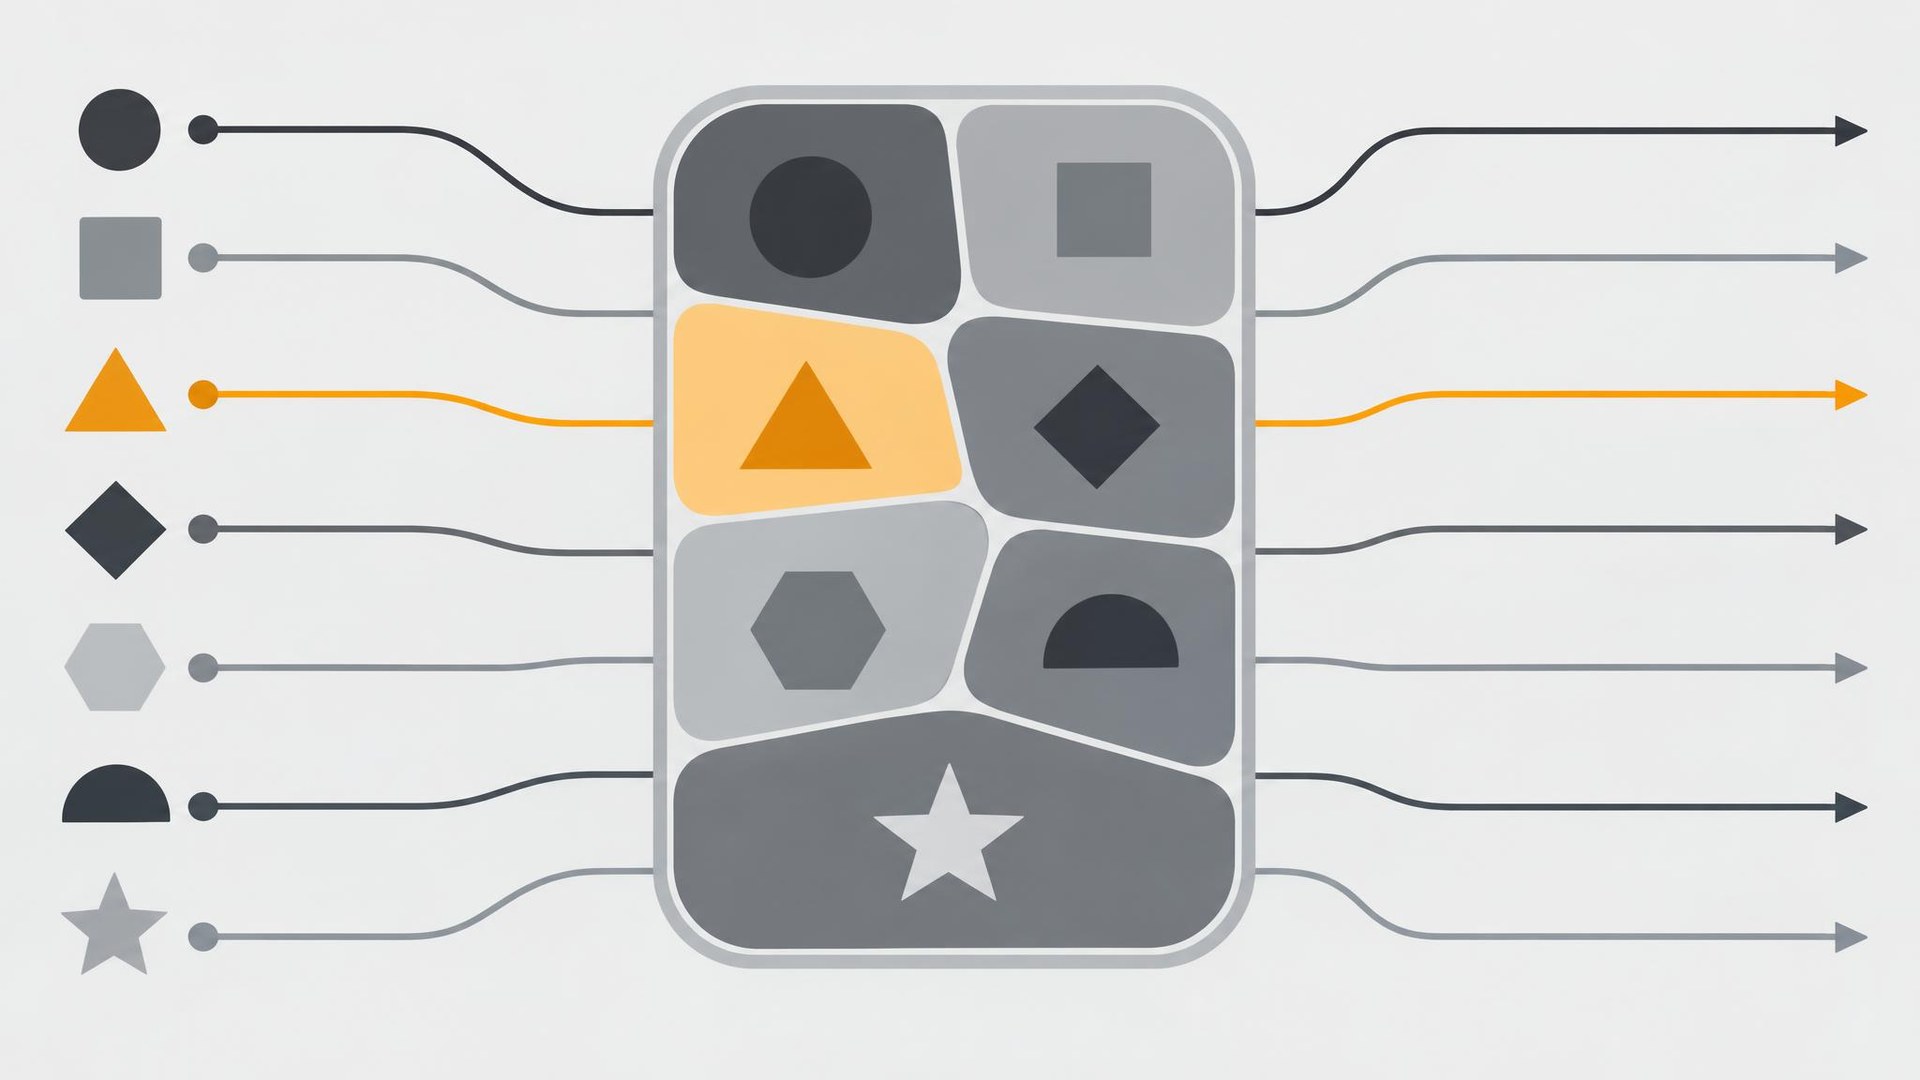
한눈에 보기
AWS가 SageMaker 실시간 엔드포인트에서 하나의 GPU를 여러 조각으로 나눠 여러 모델이 함께 쓸 수 있게 했어요. GPU 전체를 모델 하나에 주던 방식보다 자원을 더 효율적으로 쓸 수 있어요. 다만 모든 워크로드에 유리한 것은 아니에요.
핵심만 콕콕
GPU를 하드웨어 수준에서 격리된 여러 조각(파티션)으로 나눠, 각 모델이 전용 연산 자원과 메모리를 받아요.
추론 구성 요소를 쓰는 실시간 엔드포인트에서만 가능하고, 서버리스·비동기 방식은 적용되지 않아요.
AWS 테스트에서는 긴 입력이 많은 조건에서 H100 파티션이 출력 속도와 응답 지연에서 더 나았어요.
짧은 입력이나 낮은 동시 요청 환경에서는 A100 GPU 전체를 쓰는 편이 여전히 더 저렴했어요.
왜 중요할까요?
AI 모델을 서비스할 때 GPU 비용이 크게 줄어들 수 있어, 기업이 AI를 더 싸게 운영하는 데 영향을 줄 수 있어요.
점선 밑줄이 그어진 말을 누르면 용어 사전의 쉬운 풀이가 열려요.
원문 기사
AWS, SageMaker 추론 엔드포인트에 NVIDIA GPU 분할 기능 추가
Unite.AI · 2026년 11월 7일 오전 03:23 · unite.ai
Unite.AI에서 원문 읽기이 요약은 AI가 원문을 읽고 쉬운 말로 정리했어요. 틀린 내용이 있을 수 있으니 정확한 내용은 원문에서 확인해 주세요. 기사의 저작권은 Unite.AI에 있어요.