

AI · 기사
MS, 디시전 1.1 공개…LLM보다 10배 빠르고 비용은 200분의 1
지디넷코리아 ·
한눈에 보기
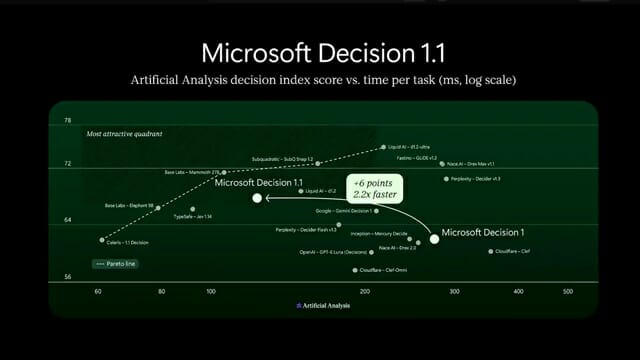
마이크로소프트가 판단 작업에 특화된 결정 모델 '마이크로소프트 디시전 1.1'을 정식 출시했어요. 대규모언어모델(LLM)을 쓰는 것보다 빠르고 싸게 반복적인 판단을 처리해 기업의 AI 운영 비용을 낮추겠다는 전략이에요. 구글의 모델을 바탕으로 만들었어요.
핵심 내용
- 마이크로소프트는 LLM을 쓰는 방식보다 10배 이상 빠르고 비용은 200분의 1 수준이라고 밝혔어요.
- 결정 모델은 긴 글을 쓰는 대신 정해진 선택지 중 답을 고르거나 점수와 확률을 내요.
- 디시전 1.1은 구글의 젬마4 26B A4B 모델을 바탕으로 추가 학습과 전용 추론 엔진(답을 만드는 계산 장치)을 적용했어요.
- 첫 모델인 디시전 1보다 처리 속도가 2배 이상 빨라졌고, 이미지와 화면 캡처도 분석할 수 있어요.
왜 중요할까요?
AI 에이전트가 작은 판단마다 대형 언어모델을 부르면 느리고 비싸서, 더 싼 결정 모델은 기업의 AI 운영 방식을 바꿀 수 있어요.
원문과 출처
MS, 디시전 1.1 공개…"기존 LLM보다 10배 빠르고 비용은 200분의 1"
지디넷코리아 · 11월 18일 06:09 KST
지디넷코리아에서 원문 읽기 ↗AI가 원문을 바탕으로 정리했어요. 틀린 내용이 있을 수 있어요. 저작권은 원 출처에 있어요. 지디넷코리아.
같은 분야의 다른 소식
- AWS 블로그: 생성형 AI 비용 줄이기, 규칙은 코드로 판단은 모델로
AWS 머신러닝 블로그는 생성형 AI 시스템에서 비용을 줄이려면 먼저 각 단계에 모델이 꼭 필요한지부터 물어봐야 한다고 설명해요. 입력 검사, 형식 변환, 경로 선택처럼 규칙으로 처리할 수 있는 단계는 모델 없이 일반 코드로 처리하면 돈과 시간을 아낄 수 있어요.
Amazon AWS Machine Learning blog · 11월 18일 06:14 KST - SageMaker AI 실시간 엔드포인트에 KV 캐시 인식 라우팅 추가
Amazon SageMaker AI에 KV 캐시 인식 라우팅(KV-aware routing)이 새로 나왔어요. 이 기능은 요청을 이미 프롬프트의 긴 앞부분을 캐시에 갖고 있고 너무 바쁘지 않은 인스턴스로 보내요. 대화형 AI처럼 긴 대화나 같은 앞부분을 반복하는 요청에서 중복 계산을 줄이는 것이 목적이에요.
Amazon AWS Machine Learning blog · 11월 18일 06:11 KST - 메타 AI 책임자, 인스타그램에 올트먼 딥페이크 영상 올려 논란
메타의 최고 AI 책임자 알렉산드르 왕이 샘 올트먼 오픈AI 대표를 등장시킨 AI 영상을 인스타그램에 올렸어요. 메타의 AI 정책상 허용되는 내용이고, 메타 AI 에이전트 '뮤즈'를 홍보하려는 목적이었어요. 이런 가짜 사진과 영상이 실제 인물에게 피해를 줄 수 있다는 지적도 나와요.
The Verge · 11월 18일 06:00 KST - 구글, Gemini 4 Carbon으로 만든 프로젝트 5개 공개
구글이 새 AI 모델 Gemini 4 Carbon으로 만든 실제 프로젝트 다섯 개를 소개했어요. 입자 시뮬레이션, 3D 가상 공간, 공공 데이터 도구 같은 복잡한 작업이 담겼어요. 개발자들은 구글 AI 스튜디오와 API에서 이 모델을 바로 써 볼 수 있어요.
Google Gemini products · 11월 18일 06:00 KST